翻译接口指南
工具集成了 9 种经典翻译 API 和 26 种大模型接口,可按文本类型、预算与隐私需求自由选择。
我应该挑哪个接口?
详细对比和申请方式往下看 ↓
经典翻译 API
要点说明:
- DeepL 不允许浏览器直连,工具默认走内置代理;如有自建代理可在设置中填入自定义 URL。
- Qwen-MT 是阿里云专为翻译训练的模型,详见下文 Qwen-MT 使用要点。
- TranslateGemma 是 Google 开源的翻译专用 Gemma,需要本地用 LM Studio / llama.cpp / koboldcpp 跑起来(不要用 Ollama,原因见下文),详见下文 本地模型接入。
- MiLMMT-46 是小米开源的翻译专用模型(同样 Gemma3 派生),语种更少但覆盖粤语,同样要本地跑,详见下文 MiLMMT。
- GTX API / Edge API 都是零配置的免费机器翻译,互为备胎——一个连不上就换另一个;细节见下文 免费机器翻译使用要点。
需要更稳定的服务,可自行申请商业 API Key,详见 接口申请教程。
大语言模型(LLM)
支持的 LLM 接口共 26 个,分两组:
- 厂商直连(16 家):DeepSeek、OpenAI、Claude、Gemini、Qwen、Kimi (Moonshot)、Doubao(火山方舟)、Xiaomi MiMo、Zhipu GLM、MiniMax、StepFun(阶跃星辰)、Baidu ERNIE(千帆)、Mistral、xAI (Grok)、Cohere、YandexGPT (AI Studio)
- 聚合网关与自托管(10 个):OpenRouter、OpenCode Zen、TokenHub(腾讯)、Groq、Cerebras、SiliconFlow、Atlas Cloud、Nvidia NIM、Azure OpenAI,以及 Custom (OpenAI-compatible) —— 任何兼容 OpenAI 协议的地址都填这一项,URL 输入框上方直接列出 LM Studio / Ollama / llama.cpp / koboldcpp / LiteLLM / Together AI / Fireworks AI 七个快捷地址
适合处理:
- 文学作品、技术文档等需要深度理解的内容
- 需要保持术语风格一致的多语种资料
- 想用自定义提示词控制翻译风格的场景
主要参数:
- 模型:可以下拉选,也可以直接输入。下拉里每条显示“友好名 + 真实 SKU”两行,该接口的默认模型带
default标签;厂商刚发布、清单里还没有的 SKU 手填即可。Azure OpenAI 填部署名。 - 温度(Temperature):默认 0.7。技术文档建议 0.2 左右,营销/意译可以放到 0.9。
- 五个接口没有这个控件:OpenAI(GPT-5.x 全系为推理模型,非默认温度直接报 400)、Claude(在册 SKU 的 adaptive / extended thinking 拒绝 temperature)、Gemini(3.x 官方建议保持默认 1.0,调低易导致循环输出)、Kimi (Moonshot)(k2.x / k3 锁定温度)、Azure OpenAI。这几家不发送该参数、UI 也不显示输入框,直接用服务端默认值——想控制文风请改用系统提示词或思考强度。
- 思考模式:让 AI 多想一步再翻译,质量更高但更慢/更贵。支持的模型会在「模型」下方多出一个下拉,选项按模型独立保存,切模型不影响别的设置。形态有四种:
- 两档(Off / On):DeepSeek(开启即最高档,底层 API 的中间档位对翻译无意义)、Doubao、Zhipu GLM、Xiaomi MiMo、MiniMax M3、Baidu ERNIE 5.0 Thinking、Mistral(Medium 3.5 / Small)、Cohere Command A Reasoning、SiliconFlow —— 这几家的底层 API 只接受 on/off,不接受 effort
- 四档(Off / Low / Medium / High):其余支持思考的接口,包括 Claude、OpenAI GPT-5.x、Gemini、Qwen3、Kimi (Moonshot)、xAI Grok、Groq 与 Cerebras 的 GPT-OSS、Azure OpenAI,以及 OpenRouter 上带思考标记的模型
- 最低档标 Min 而不是 Off:厂商压根没给关闭值的模型,最低一档改标 Min —— 它照常推理、照常计费,标成 Off 是撒谎。当前是 Gemini 3.x、xAI Grok 4.5 / 4.6、Groq 与 Cerebras 上的 GPT-OSS、Kimi K3 / K2.6,外加单个 SKU Claude Fable 5(官方标 Always on,发显式关闭直接 400;同门的 Opus 5 / Sonnet 5 / Haiku 4.5 都关得掉)
- 三态(Off / On / Auto):在支持思考的接口上填未列出的自定义模型时。Auto = 省略思考参数、跟随模型自带默认(用于严格 provider 对非思考 SKU 会报错时的兜底);默认 Off
- 不显示思考控件:StepFun、YandexGPT、OpenCode Zen、TokenHub、Atlas Cloud、Nvidia NIM、Custom (OpenAI-compatible)。聚合网关背后是多家上游,「能不能关思考」逐个型号不同,统一发关闭参数会打到不支持关闭的型号上,因此一律跟随上游模型的服务端默认
部分接口的特别说明
- TokenHub(腾讯):腾讯混元已迁到 TokenHub,除自研 hy3 外还转售 DeepSeek / GLM / Kimi / MiniMax / MiMo。⚠ 光有 API Key 调不通 —— 每个模型都要先在控制台的「在线推理」页开通(开启免费体验或启用后付费),否则任何调用都返回 400
401006「输入的服务 ID 不存在」。官方端点只在成功响应上发 CORS 头、预检一律 405,浏览器直连必败,因此「中转 API」默认开启。 - OpenCode Zen:聚合网关,模型清单里带
(free)后缀的 SKU 用起来免费——需要注册并绑定账单信息,但不预付费。上游完全不发 CORS 头、预检返回 404 页面,因此「中转 API」同样默认开启。 - Cerebras:收录它是为了速度而不是模型(两个公共模型在 Groq / Nvidia / SiliconFlow 上都调得到)。官方标称 gpt-oss-120b 约 3000 tokens/s,逐行翻译这类高频短请求体感明显;另有每日 100 万免费 token。
- YandexGPT (AI Studio):除 API Key 外还需填写 Folder ID(在 Yandex AI Studio 控制台的目录页获取)。模型字段填 SKU 名(如
yandexgpt-5.1,也提供 Qwen3、DeepSeek、GPT-OSS 等开源 SKU),或直接粘贴完整的gpt://<folder_id>/<model>/latestURI。Yandex 官方接口无 CORS 头,浏览器无法直连,「中转 API」默认开启(开关可关闭,也可改填自建中转地址)。 - 已从服务列表移除的接口:GitHub Models(2026-07-30 官方整家退役)、Perplexity Sonar(chat/completions 提前下线)、Tencent Hunyuan 旧端点(迁至 TokenHub)。LiteLLM 不再是独立条目,改为 Custom (OpenAI-compatible) 的一个 URL 快捷项,见下文 自建网关与第三方推理平台。
区域端点切换
不少接口在国内、海外、美国有不同的接入地址,URL 输入框上方会以快捷标签列出官方地址,点击即可切换:
URL 自动补全
Claude 与全部走 OpenAI 协议的接口(含 Custom、TranslateGemma、MiLMMT、Qwen / Qwen-MT、Nvidia、YandexGPT 等)的 URL 字段,在切走焦点时会立即补全为完整路径;其余接口填写的自定义 URL 也会在请求发出前自动规范化。粘贴 http://host:port 或 http://host:port/v1 即可,不会再出现“少写 /v1/chat/completions 导致连不上”的问题。
免费机器翻译使用要点
工具内置三个零配置的免费机器翻译——GTX (Free)、Edge (Free)、DeepLX (Free),都不需要 API Key,从你的浏览器直连官方接口,文本不经过本工具的服务器。它们走不同的链路,互为备胎:一个连不上,下拉换另一个即可,不必申请任何 Key。GTX 是默认服务。
GTX 网关可切换
GTX 默认走 translate-pa.googleapis.com(Google 网页翻译组件用的同一个网关,跨域规范、可用性好)。URL 输入框上方提供快捷切换:
- translate-pa(默认):推荐,多数网络环境可用
- Legacy gtx:旧版
translate.googleapis.com/translate_a端点。Google 已对它收紧反滥用策略(很多 IP 会被跳转到验证页,浏览器据此报 CORS),但封锁按 IP 信誉判定,部分地区/网络仍可用,故保留作备选 - 自建镜像:URL 填你自己用 Cloudflare Worker 等搭的镜像地址即可,工具按地址形态自动识别协议
速率限制与自动降速
免费共享端点按使用方限流。GTX 现在采用整批分块翻译——把多行拼成约 5000 字符一块、一块一个请求,请求数相比逐行翻译大幅减少,日常使用基本不会触发限流。短时间超大批量仍可能限流,工具会自动处理:
- 触发限流后自动暂停该服务的所有请求,稍候自动恢复,并提示「请求过于频繁,已自动暂停片刻后重试」
- 期间翻译变慢但会继续推进,绝大多数情况无需任何操作
- 若失败面板仍频繁出现限流提示:等几分钟再点「重试失败行」(缓存会跳过已完成的行),或换 Edge (Free) / DeepLX (Free) 这两个免费备胎;长期大批量任务建议换 DeepL / Qwen-MT / DeepSeek 等带 Key 的服务
连不上或控制台出现 CORS 报错?先换网关或换 Edge (Free)——多数情况一步解决;仍不行再排查网络环境(大陆屏蔽、公司网络拦截、浏览器扩展拦截),步骤见 常见问题 → GTX 连不上。
Qwen-MT 使用要点
阿里云的 Qwen-MT 是机器翻译类服务,与通用 LLM 不同——它没有 system prompt 概念,只用源/目标语言代码工作,因此 Prompt 设置对它不生效。
模型选择
API 设置的 模型 字段可下拉选择,也可手填:
旧的
qwen-mt-turbo已被阿里云标记弃用,不再列在下拉里。
领域提示(domains)
domains 字段告诉模型当前文本所处的行业,让术语更专业。注意:填一段英文自然语言,不是关键词列表。阿里官方示例:
不需要时留空即可。
原生术语表通道
Qwen-MT 是少数支持原生术语表的 MT 服务:启用 术语表 后,命中的词条会通过官方 translation_options.terms 参数随请求发送,由模型在翻译时原生应用,比提示词注入更可靠。
不支持的语言
Qwen-MT 官方约 92 种语言,部分低资源语言暂未覆盖,UI 会自动提示并阻止使用(以应用内实际拦截为准):如柯尔克孜(ky)、土库曼(tk)、塔吉克(tg)、蒙古(mn)、马拉雅拉姆(ml)、维吾尔(ug)、阿姆哈拉(am)等数十种。
中转 API 与内置代理
部分接口的官方端点不允许浏览器直连(CORS 限制)。工具提供两类代理通道,文本都不经过本工具的服务器存储。
中转 API(可控开关)
除 Gemini、Nvidia NIM、Azure OpenAI、Custom 之外的每个 LLM 接口(共 22 个:DeepSeek、OpenAI、Claude、Qwen、Kimi (Moonshot)、Doubao、Xiaomi MiMo、Zhipu GLM、MiniMax、StepFun、Baidu ERNIE、Mistral、xAI (Grok)、Cohere、YandexGPT、OpenRouter、OpenCode Zen、TokenHub、Groq、Cerebras、SiliconFlow、Atlas Cloud)都在 API 设置里提供「中转 API」开关,开启后请求经由内置的 Cloudflare 转发(只转发请求本体与鉴权头):
- 大多数接口默认关闭——直连遇到 CORS / 403 报错时,界面会用可行动提示引导你开启
- OpenCode Zen、TokenHub、YandexGPT 默认开启:这三家的官方端点目前都无法从浏览器直连(前两家的预检分别返回 404 / 405,Yandex 干脆不发 CORS 头),默认开才能开箱即用;开关保留,官方修复后可自行切回直连
- 端点由用户掌控的接口没有这个开关:Custom、Azure OpenAI、Nvidia NIM 的地址本就是你自己填的,中转没有固定上游可写;Gemini 把模型名拼在 URL 路径里,pass-through 转发不了
- 自建中转:不想走共享中转,把自己部署的转发地址填入 URL 字段即可。优先级固定为 自定义 URL > 中转开关 > 官方直连——URL 已填时中转开关会置灰,并提示「清空 URL 后恢复」
- 中转会透传服务器的
Retry-After响应头,限流时的自动降速与直连一样精确
内置代理(无开关)
DeepL 与 Nvidia NIM 默认经另一组内置代理转发;在设置里填了自定义 API URL 时代理被绕过,请求直接发到你填的地址。
本地模型接入
希望自己跑模型保护隐私?工具支持任何兼容 OpenAI 协议的本地服务。为了翻译质量,通用 LLM 建议 qwen3-14b 及以上参数规模(32B 级更好);显存有限时可改用翻译专用的 TranslateGemma 或 MiLMMT,4B 起就有不错的翻译质量(这两个请用 LM Studio / llama.cpp / koboldcpp 跑,别用 Ollama——原因见下)。
国内用户下载模型推荐 魔搭 ModelScope,比 Hugging Face 直连 / LM Studio 内置源快得多,TranslateGemma 官方仓库也有同步。
本地服务器多为单并行槽(llama.cpp 默认 --parallel 1,LM Studio 的 Max Concurrent 也只有个位数),而本工具默认并发 10。多出来的请求会在服务端排队,而每个请求的超时钟从发出就开始走 —— 慢机器上排在后面的请求会在还没轮到它时就超时。
先把服务设置里的「调用参数 → 并发行数」降到 2-4(或调到与你服务器的并行槽数一致),再考虑提高「高级设置 → 超时时间」。降并发往往不会变慢:服务器本来就是一个一个算的。
默认接口地址
URL 输入框旁会列出这些地址作为快捷选项;点中哪个,下方就出现那个运行时的官方文档链接(先把服务跑起来、把模型名弄对,这一步的问题官方文档才答得了)。
这两个服务把提示词预渲染后打 /v1/completions,整条设计的前提是「服务端不再套任何模板」。Ollama 在这个端点上仍然会套 Modelfile 模板——源码三行为证(2026-08-22 核对 ollama/main):
api/types.go:// Raw set to true means that no formatting will be applied to the prompt.openai/openai.go:FromCompleteRequest构造api.GenerateRequest时没有设Raw→ 默认falseserver/routes.go:if !req.Raw { tmpl := m.Template … }
结果是预渲染好的提示词被再包一层(包成什么取决于导入时那个 GGUF 带的模板,客户端完全控制不了),译文质量会莫名其妙地差,而且不报错。因此这两个服务的快捷选项里没有 Ollama——请用 LM Studio / llama.cpp / koboldcpp。
(Custom (OpenAI-compatible) 走的是 /v1/chat/completions,Ollama 在那里套模板正是应该的,不受影响。)
koboldcpp 是单文件 exe 的 llama.cpp 封装(不用安装、双击就跑、自带网页界面),默认 5001 端口同时提供 KoboldAI 与 OpenAI 两套接口。
自建网关与第三方推理平台
除了四个本地运行时,Custom (OpenAI-compatible) 的 URL 快捷项里还有三个非本地地址,选中即填、不必手打:
LiteLLM 曾经是独立的服务条目,现已并入 Custom —— 它和 Together / Fireworks 一样只是「一个 OpenAI 协议地址」,独占一个服务槽位没有意义。原来那些用法照旧成立:
- URL 即凭证,API Key 可选(本地裸跑不填;代理配置了 master / virtual key 时填上)
- 模型名可留空:用
litellm --model X启动(官方 quick start 方式)或设置了completion_model服务端默认时,留空即走服务端默认模型;config.yaml 多模型部署则填模型别名
TranslateGemma
Google 推出的翻译专用 Gemma 模型,针对翻译质量做了专门训练。使用要点:
- 请在服务列表里直接选「TranslateGemma」——不要走「Custom (OpenAI-compatible)」+ 填
translategemma-4b-it模型名。两者是完全不同的代码路径:独立的 TranslateGemma 服务走逐行调用,专门匹配 Gemma 翻译模型的输入输出格式;Custom 走的是带批次/上下文标记的 LLM 通用路径,对 14B 以下的小模型容易漏行、速度也更慢。 - 默认地址指向 LM Studio 1234 端口,可一键切换到 llama.cpp / koboldcpp。不要用 Ollama,原因见上方提示框
- API Key 可选:本地裸跑无需填写;若服务端开了鉴权(LM Studio 的 "require API key"、vLLM 的
--api-key、或反向代理加的认证层),填上即可,请求会附带Authorization: Bearer头 - 推荐模型:普通家用电脑首选
translategemma-4b-it——轻量快速、输出干净。translategemma-12b-it/27b-it质量更高,但显存与算力要求也更高 - 模型名可以留空:留空就不发模型名,用你运行时当前加载的那个。模型 id 由运行时决定(LM Studio / Ollama / llama.cpp 各报各的,量化后缀也可能在里面),报 404「模型不存在」时,清空这个字段通常比猜名字快
- 12B 的「多选项」噪音:这是模型自身行为,并非接入问题。实测 12B 常对同一句给出多个候选译法,且没有固定格式、工具无法自动过滤,译文里会夹带大量噪音。家用设备建议直接用 4B;要用 12B 时先用小段文本验证输出是否干净再批量跑
- Prompt 设置对它不生效:和 Qwen-MT 一样属于机器翻译类服务,提示词已内置在调用格式里,系统/用户 Prompt 只对 LLM 类接口生效
- 必须明确指定源语言——这个模型不支持"自动检测"
- 语言覆盖较小:工具内可选 53 种主流语言(对齐 Google WMT24++ benchmark),其余 69 种——包括粤语 yue、博杰普尔 bho、沃洛夫 wo、阿拉贡 an、瓜拉尼 gn、库尔德 ckb/kmr——会被 UI 直接拦截。需要更广语种请改用 DeepL / Google / Azure / Qwen-MT
MiLMMT
小米开源的翻译专用模型 MiLMMT-46(同为 Gemma3 派生,1B / 4B / 12B 三档,社区有 GGUF 量化)。与 TranslateGemma 用法几乎一致,但有一条它独有的坑:
- 请在服务列表里直接选「MiLMMT」——这一条比 TranslateGemma 更硬。小米在模型讨论区明确说明,后训练阶段模型的指令跟随能力已被大幅剥离,标签与指令会被当成正文噪声。走「Custom (OpenAI-compatible)」时系统提示词会被原样拼进输入,翻译质量直接崩坏;本工具的 MiLMMT 服务按官方模型卡的固定格式逐行调用,不掺任何提示词
- 默认地址指向 LM Studio 1234 端口,可一键切到 llama.cpp / koboldcpp。不要用 Ollama,原因见上方提示框
- API Key 可选:本地裸跑无需填写;服务端开了鉴权时填上即可
- 推荐模型:默认
MiLMMT-46-4B-v1.0(家用显卡够用),另有 1B(纯 CPU 可跑)与 12B(质量更高) - 模型名要与运行时里实际加载的一致,实在不确定就留空:留空就不发模型名,用当前加载的那个。报 404「模型不存在」时这比猜名字快
- Prompt 设置、术语表、上下文翻译对它全部不生效——原因同上,模型收不了指令。需要术语一致性请改用 LLM 类接口或 Qwen-MT
- 必须明确指定源语言——提示词里写死了源语言名,模型没有"自动检测"模式
- 语言覆盖 47 种(官方称 46 语言家族):支持粤语 yue(TranslateGemma 不支持),另有哈萨克/乌兹别克/阿塞拜疆/老挝/缅甸/高棉/马来语;但不含乌克兰语 uk、塞尔维亚语 sr、立陶宛/拉脱维亚/爱沙尼亚语,印度语系只到孟加拉/印地/泰米尔/乌尔都。不支持的语种会被 UI 直接拦截。与 TranslateGemma 共同支持 39 种
官方也说明下一版会补回指令跟随与术语表支持;在那之前,把它当纯机器翻译引擎用。
解决 CORS 跨域
浏览器调用本地模型时若连不上,最常见的两个原因:
步骤 1|排查广告/隐私插件:先暂时禁用浏览器的拦截扩展,刷新重试。
步骤 2|为本地服务开启 CORS:
Ollama
在 PowerShell(Win + X 打开终端)粘贴一行命令永久启用:
*允许所有来源;想更严格可换成具体域名,例如http://192.168.2.20:3000。
设置后重启 Ollama 服务即可生效。临时启用也可以在启动时加环境变量:
LM Studio
- 打开左侧菜单的「Developer」图标
- 进入本地服务器设置页,点顶部「Settings」
- 勾选「Enable CORS」复选框
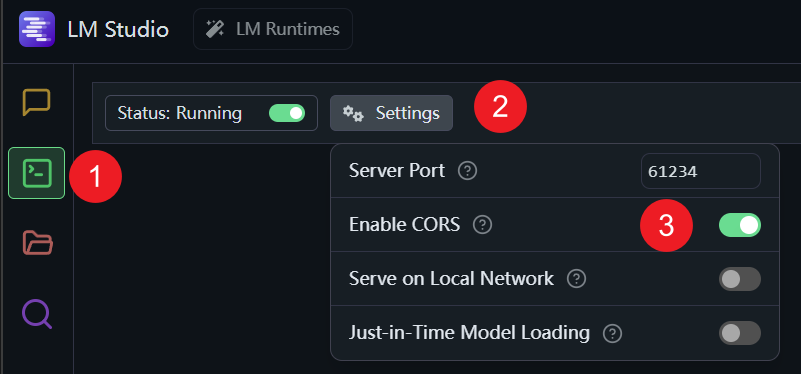
完成后即可正常调用本地模型。仍连不上的话,检查端口占用情况和浏览器控制台的报错信息。(特别感谢 mrfragger 分享配置经验)
语言支持
本工具支持 120+ 种主流语言互译,按地区分组展示。
语言代码对照表
批量配置多语言时,使用下方语言代码(如 en, zh, ja, ko):
常用
欧洲
中东
中亚
南亚
东南亚
非洲
美洲与大洋洲
API 支持文档
LLM 可支持所有语言,机器翻译 API 语言支持如下: